

Современные языковые модели уже умеют работать с договорами: находить спорные условия, объяснять риски и предлагать новые формулировки. Поэтому у юриста возникает закономерный вопрос: зачем использовать специализированный сервис и отдельно настраивать правила проверки, если договор можно загрузить напрямую в ChatGPT, Claude или другую сильную модель?
Мы решили проверить, насколько на результат действительно влияет плейбук — набор заранее заданных юридических правил, по которым ИИ анализирует договор.
Для исследования подготовили договор с известным набором рисков и протестировали восемь языковых моделей. Причем использовали не короткую команду «найди риски», а подробный промпт с описанием задачи. Всего провели 160 проверок. В статье рассмотрим три показательных сравнения — Claude Opus, Gemini и GPT — и разберемся, как изменилось качество анализа после добавления плейбука.
Содержание
Что такое плейбук и зачем он нужен ИИ
Когда юрист загружает договор в обычную нейросеть, он может подробно описать задачу: проверить ответственность сторон, порядок оплаты, сроки, расторжение и другие условия.
Но даже хороший промпт не определяет все критерии проверки. Модели приходится самостоятельно решать, какое условие считать рискованным, насколько серьезным является отклонение и какие исключения учитывать.
Например, юрист просит ИИ проверить ответственность поставщика. Модель находит неустойку и ограничения ответственности, но сама определяет, какие положения создают существенные риски.
При этом для одной компании ограничение ответственности определенной суммой может быть приемлемым, а для другой — противоречить внутренним требованиям к заключению сделок.
Такие особенности можно закрепить в плейбуке. В нем заранее описывают, какие условия допустимы, какие требуют согласования и при каких обстоятельствах необходимо предложить изменения.
По сути, промпт ставит перед ИИ задачу, а плейбук определяет критерии ее выполнения. Это особенно важно для юридических департаментов, где несколько специалистов проверяют договоры по единым корпоративным требованиям.
Как проводили исследование
Для теста подготовили договор с заранее известным набором рисков. Ответы моделей сравнивали с эталоном и оценивали, какие проблемы ИИ нашел, сколько пропустил и насколько правильно их интерпретировал.
Каждую модель тестировали в нескольких конфигурациях: с плейбуком и без него, с доступом к интернету и без доступа.
Качество проверки оценивали по трем показателям.
Полнота показывает, какую часть существующих рисков модель смогла найти. Например, если в договоре заложено десять рисков, а ИИ обнаружил шесть, полнота составит 60%.
Точность показывает, насколько корректно модель оценила найденные проблемы, не преувеличивая и не занижая их значимость.
Успешность — доля запусков, которые прошли установленный в исследовании порог качества. Этот показатель позволяет оценить стабильность результатов.
Для общего сравнения использовали метрику F1, которая объединяет полноту и точность:
F1 = 2 × (полнота × точность) / (полнота + точность).
Если модель находит почти все риски, но часто ошибается при их оценке, итоговый F1 снижается. То же происходит, когда ИИ правильно оценивает найденные проблемы, но пропускает значительную часть остальных.
Как плейбук повлиял на результаты проверки
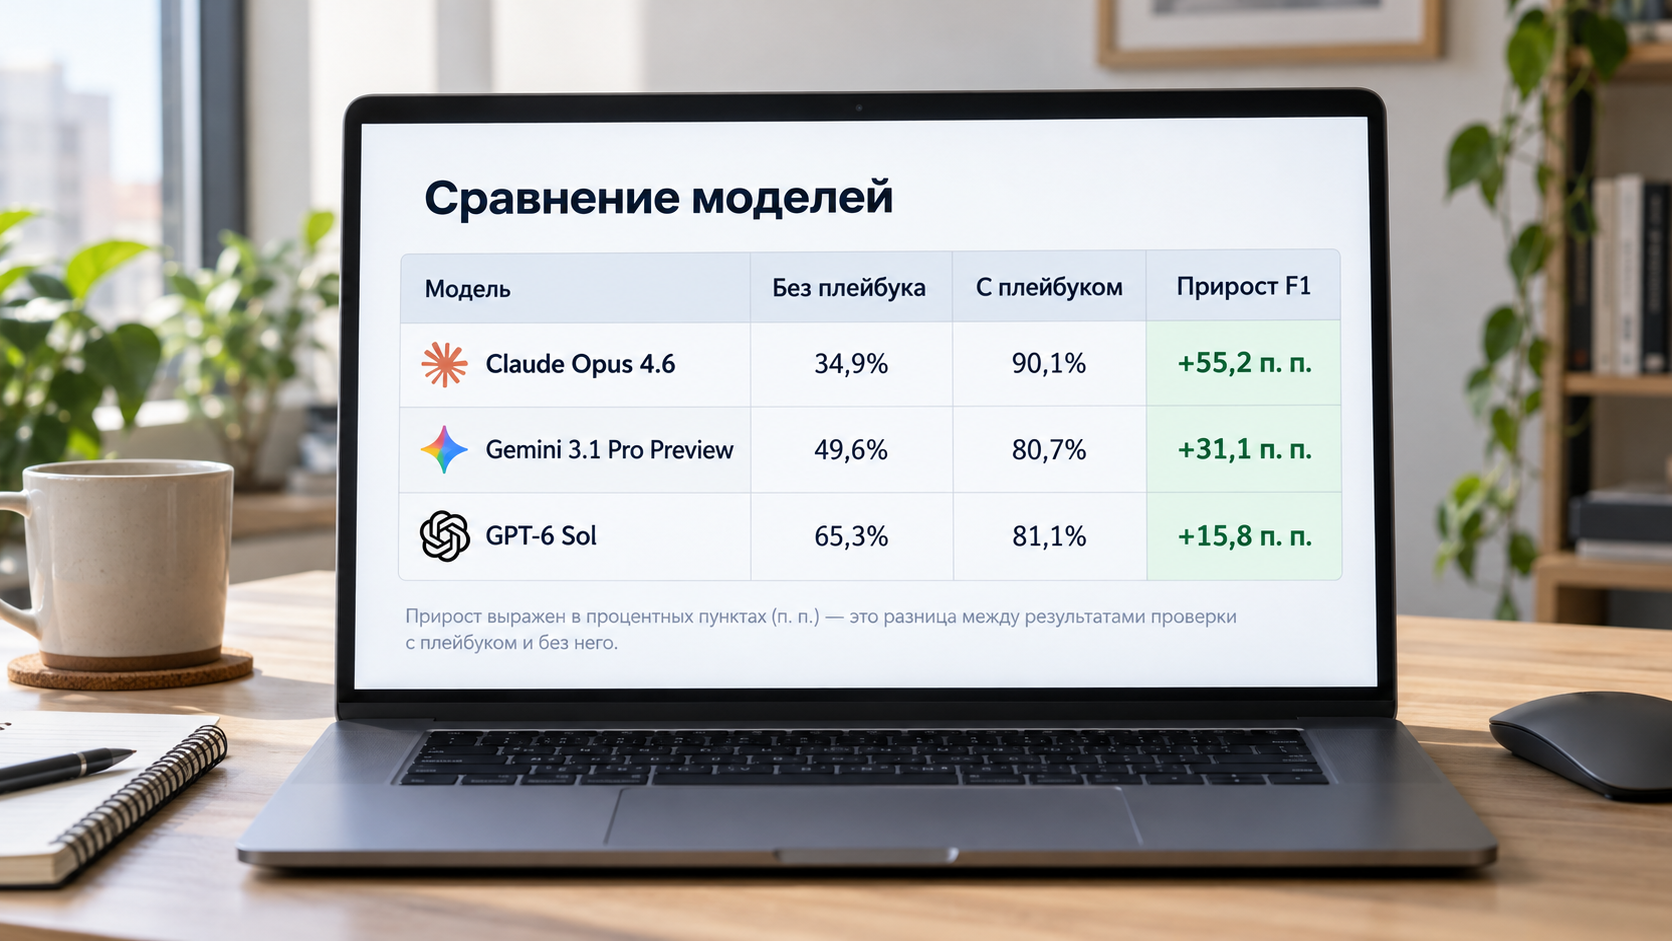
Для статьи мы выбрали три показательных сравнения: Claude Opus 4.6, Gemini 3.1 Pro Preview и GPT-6 Sol. В каждом случае сопоставляли результаты одной модели при одинаковых настройках, меняя только наличие плейбука.
| Модель | Без плейбука | С плейбуком | Прирост F1 |
|---|---|---|---|
| Claude Opus 4.6 | 34,9% | 90,1% | +55,2 п. п. |
| Gemini 3.1 Pro Preview | 49,6% | 80,7% | +31,1 п. п. |
| GPT-6 Sol | 65,3% | 81,1% | +15,8 п. п. |
Указан итоговый показатель F1. Прирост выражен в процентных пунктах (п. п.) — это разница между результатами проверки с плейбуком и без него. Три сравнения выбраны из более широкого исследования и показывают эффект плейбука в конкретных конфигурациях.
Наиболее заметную разницу получили при тестировании Claude Opus. После добавления плейбука F1 вырос с 34,9% до 90,1% — на 55,2 процентного пункта. При этом речь идет об одной из самых мощных языковых моделей, которая и без дополнительных правил способна анализировать сложные документы. Однако в нашем тесте подробного промпта оказалось недостаточно для качественной проверки договора.
У Gemini 3.1 Pro Preview показатель увеличился с 49,6% до 80,7%. Причем улучшилась не только полнота проверки — с 42,7% до 70,7%, но и точность оценки рисков — с 59,2% до 94,1%. Модель стала обнаруживать больше действительно существующих проблем и реже ошибаться в их оценке. Для юриста это особенно важно: большое количество замечаний само по себе не делает проверку полезнее, если значительную часть из них приходится перепроверять и отсеивать вручную.
У GPT-6 Sol результат также вырос — с 65,3% до 81,1%. Даже при сравнительно высоком исходном показателе дополнительные юридические правила позволили улучшить качество анализа.
Главный результат этих сравнений — даже сильной языковой модели недостаточно просто подробно объяснить задачу. Без заранее заданных критериев ИИ самостоятельно определяет, какие условия считать рискованными и насколько серьезными являются найденные проблемы. Плейбук позволяет передать ему конкретные юридические требования и оценивать договор относительно них.
Как качество проверки связано с ее стоимостью
В исследовании отдельно оценивали стоимость обработки запросов. Она зависит от модели, объема документа, длины инструкций и других параметров.
При этом более высокая стоимость не всегда означает лучший результат. В некоторых случаях менее затратная конфигурация с подготовленными юридическими правилами способна приблизиться к показателям более мощной нейросети.
Для понимания экономики рассмотрим условный пример: если одна проверка стоит X, а другая — 2X, при обработке сотен договоров разница в расходах становится существенной. Это иллюстрация, а не измеренное соотношение стоимости моделей из исследования.
Поэтому при выборе ИИ для регулярной договорной работы важно учитывать не только качество анализа, но и стоимость его получения.
Почему подготовка плейбука требует отдельной работы
На первый взгляд юридический плейбук можно составить самостоятельно: собрать основные требования компании и передать их нейросети вместе с договором.
На практике подготовка правил требует юридической экспертизы. Для каждого условия необходимо определить критерии оценки, возможные исключения и обстоятельства, при которых возникает риск.
Затем плейбук тестируют на договорах: проверяют, какие проблемы модель обнаруживает, что пропускает и какие инструкции требуют уточнения.
Как показало исследование, один и тот же набор правил может по-разному влиять на работу языковых моделей. Поэтому плейбук необходимо не только составить, но и проверить на совместимость с выбранной моделью.
Для юриста, который ежедневно работает с договорами, такая подготовка становится отдельной задачей. Особенно если правила приходится регулярно обновлять вслед за изменениями законодательства или внутренних требований компании.
Что это значит для юристов
Универсальные языковые модели уже позволяют проверять договоры без специализированных сервисов. Однако при регулярной договорной работе на первый план выходит воспроизводимость качества. Недостаточно, чтобы ИИ один раз хорошо проверил договор, а при следующем запуске пропустил существенные риски или оценил аналогичные условия иначе. Компаниям важно получать предсказуемый результат по единым критериям, независимо от конкретного сотрудника, который занимается проверкой.
Особенно это актуально для договорных отделов, где с документами работают несколько юристов. Плейбук помогает стандартизировать проверку: закрепить общие требования к оценке рисков и снизить зависимость результата от индивидуального подхода специалиста. При этом плейбук не исключает ошибок модели, поэтому качество его применения необходимо контролировать.
Наше исследование показало, что в ряде конфигураций добавление плейбука увеличивало F1 на десятки процентных пунктов. При этом качество зависит не только от возможностей языковой модели, но и от подготовки самих правил.
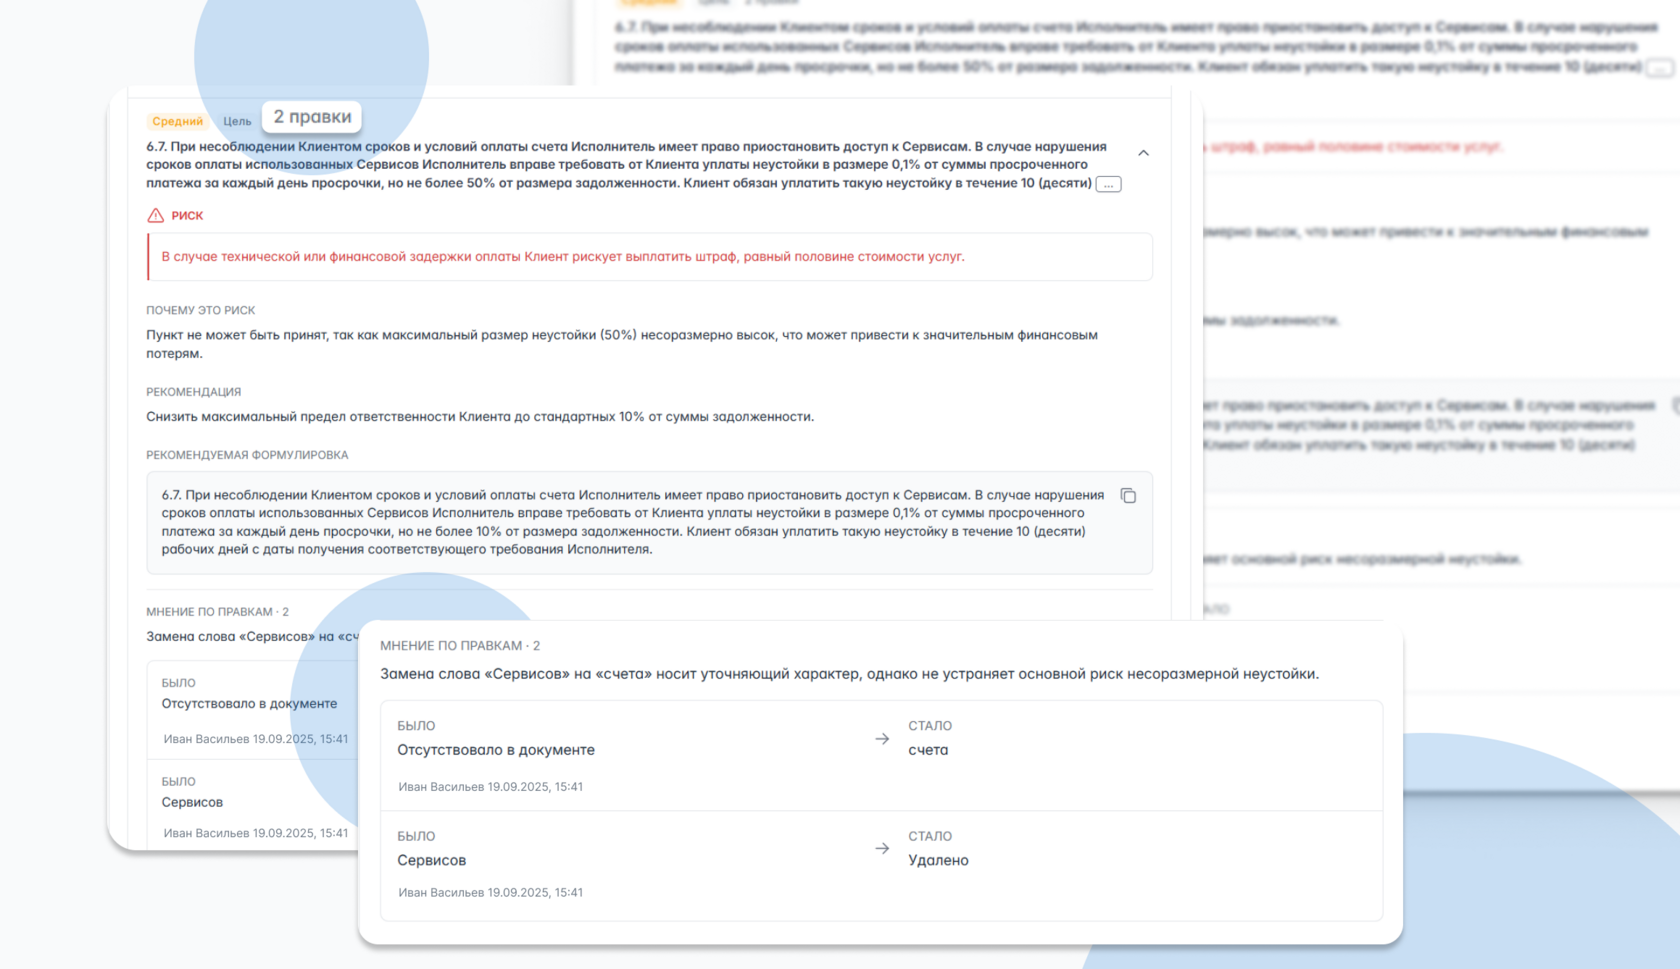
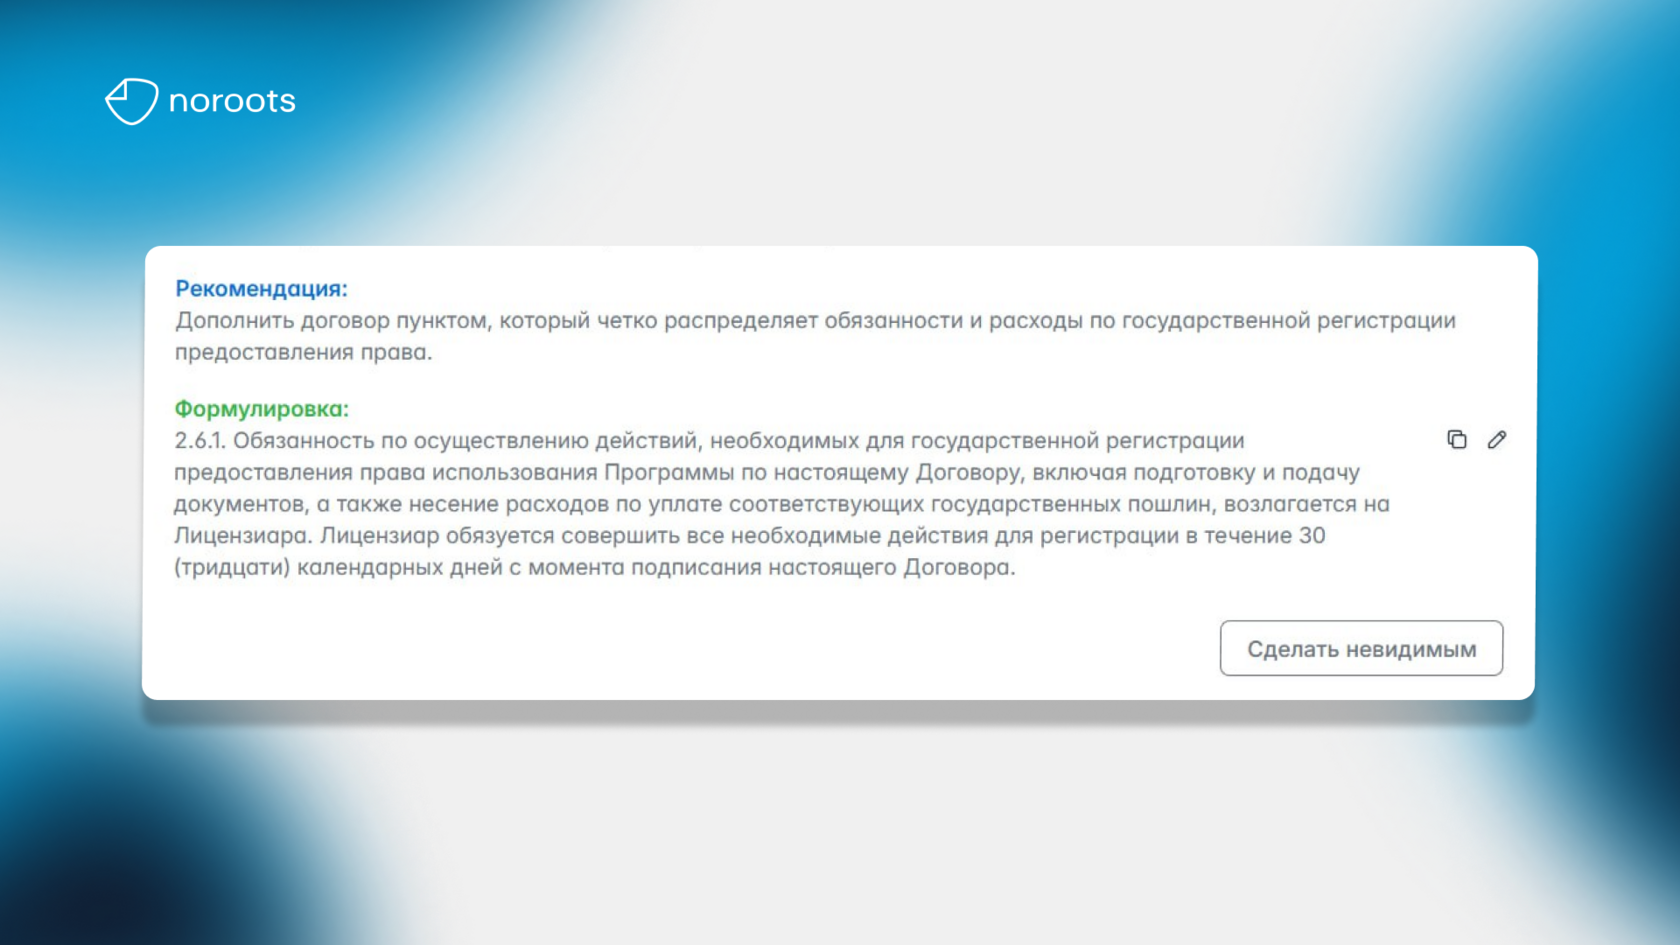
Такой подход используется в noroots. В сервисе уже подготовлены юридические плейбуки, по которым ИИ анализирует договоры. Например, один из них включает более 50 правил и занимает около десяти страниц текста с критериями оценки условий, ограничениями и исключениями. Более того каждое правило дополнили ссылками на нормативно-правовые акты и судебную практику, которые обосновывают соответствующие требования. Поэтому вместе с найденным риском юрист получает не только замечание к договору, но и правовое обоснование. Это особенно полезно при согласовании спорных условий, когда необходимо объяснить руководству или контрагенту, почему компания предлагает изменить конкретный пункт договора.
Юристу не нужно самостоятельно составлять многостраничные инструкции и тестировать их на разных моделях. Сервис проводит проверку по подготовленным правилам, находит потенциальные риски и предлагает их для дальнейшей работы.
В результате юрист может сосредоточиться на оценке замечаний и согласовании условий договора, а подготовку и настройку правил проверки берет на себя noroots.